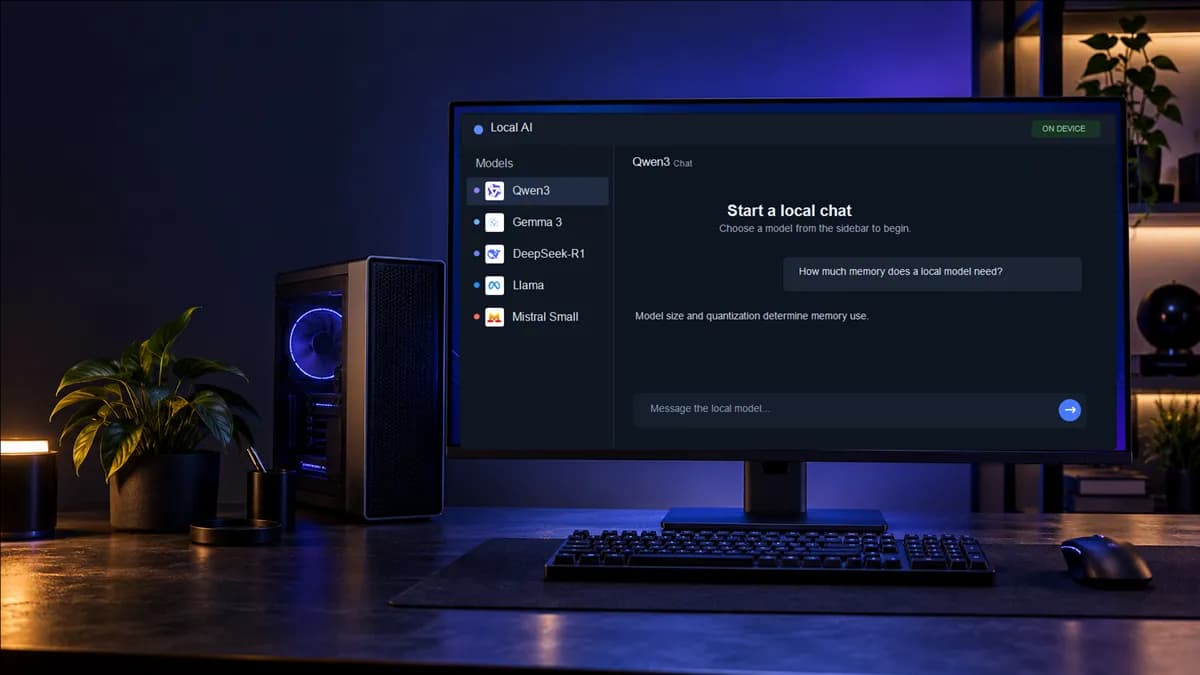
برای اجرای هوش مصنوعی روی کامپیوتر شخصی، مدلهای کوچکتر خانوادههایی مثل Qwen3 و Gemma 3 نقطهی شروع مناسبی هستند. انتخاب مدل به حافظهی سیستم، نوع کار، کیفیت فارسی، سرعت مورد انتظار و مجوز همان نسخه بستگی دارد. در این راهنما مدلهای عمومی، استدلالی و کدنویسی را مقایسه میکنیم و دربارهی حافظه، اجرای محلی، حریم خصوصی و انتخاب مدل مناسب توضیح میدهیم.
اگر میخواهید هوش مصنوعی را روی کامپیوتر شخصی اجرا کنید، برای شروع یک مدل ۴ تا ۸ میلیاردپارامتری از خانوادهی Qwen3 یا Gemma 3 انتخاب کنید. برای استدلال، DeepSeek-R1 تقطیرشده را امتحان کنید؛ برای کدنویسی سراغ مدلهای تخصصی مثل Qwen Coder بروید. انتخاب نهایی به حافظهی دستگاه، زبان و کار شما و مجوز همان نسخه بستگی دارد.
اجرای مدل هوش مصنوعی لوکال یعنی فایل مدل روی رایانهی خودتان بارگذاری شود و پرسشها برای تولید پاسخ به سرور یک سرویس ابری فرستاده نشوند. این کار میتواند به حفظ حریم خصوصی، استفادهی آفلاین و کنترل بیشتر کمک کند؛ اما به معنی سرعت بالا روی هر دستگاه یا محرمانهماندن خودکار همهی فایلها نیست. نرمافزار و تنظیمات شما هم باید امن باشند.
جدول مقایسهی مدلهای هوش مصنوعی قابل اجرا روی کامپیوتر
| مدل | مناسب برای | اندازهی پیشنهادی برای شروع | مزیت برجسته | محدودیت اصلی |
|---|---|---|---|---|
| Qwen3 | کارهای عمومی، فارسی، کدنویسی | 4B یا 8B | چندزبانه و انتخابهای متنوع | مدلهای بزرگ به حافظهی زیادی نیاز دارند |
| Gemma 3 | گفتوگو و تحلیل تصویر | 4B یا 12B | نسخههای چندرسانهای و اندازههای گوناگون | مجوز اختصاصی و کیفیت فارسی وابسته به کاربرد |
| DeepSeek-R1 | استدلال و حل مسئله | 7B/8B یا 14B | نسخههای تقطیرشدهی قابل اجرا | پاسخ طولانی و سرعت کمتر در حالت استدلال |
| Llama | چت عمومی و سازگاری با ابزارها | نسخهی کوچک 8B | اکوسیستم گسترده | مجوز استفادهی اختصاصی و تفاوت زیاد بین نسخهها |
| Mistral Small | کارهای دشوارتر روی رایانهی قوی | حدود 24B | توان مناسب در یک مدل نسبتاً جمعوجور | مصرف حافظه و تفاوت مجوز بین نسخهها |
| Qwen Coder و مدلهای کدنویسی | تکمیل و توضیح کد | 7B تا 14B | تمرکز بر زبانهای برنامهنویسی | کد خروجی همچنان نیازمند آزمون و بازبینی است |
اندازهها در جدول نقطهی شروعاند، نه تضمین سازگاری. کوانتایزیشن (فشردهسازی وزنها)، طول گفتوگو، نسخهی مدل و نرمافزار اجرا روی مصرف حافظه اثر میگذارند. در ادامه ویژگیها، مزایا و معایب هر خانواده را جداگانه میخوانید.
۱. Qwen3؛ انتخاب همهکاره برای شروع
Qwen3 خانوادهای از مدلهای متنی با اندازههای کوچک و بزرگ است. مدلهای کوچکتر برای چت، بازنویسی متن، خلاصهسازی و پرسشوپاسخ روزانه مناسباند؛ اندازههای بالاتر در استدلال، کدنویسی و کارهای چندمرحلهای ظرفیت بیشتری دارند. این خانواده چندزبانه است و میتواند گزینهای برای آزمایش فارسی باشد، ولی کیفیت فارسی را با پرسشهای واقعی خودتان بسنجید.
مزایا: تنوع اندازه برای سختافزارهای مختلف؛ توانایی عمومی در چند نوع کار؛ گزینههای تخصصی کدنویسی در خانوادهی Qwen.
معایب: نسخههای بزرگ به RAM یا VRAM بیشتری احتیاج دارند؛ کیفیت پاسخ فارسی بین نسخهها یکسان نیست؛ بعضی گونههای MoE با عدد پارامتر فعال کمتر هم ممکن است حافظهی زیادی برای بارگذاری کل وزنها بخواهند.
مناسب چه کسی است؟ کسی که یک دستیار محلی عمومی میخواهد و دوست دارد مدل را با اندازههای مختلف روی دستگاهش مقایسه کند.
بیشتر بخوانید : بهترین کامپیوترها برای اجرای هوش مصنوعی بهصورت لوکال
۲. Gemma 3؛ متن و تصویر در یک خانواده
Gemma 3 از خانوادههای مدل گوگل است که چند اندازه از سبک تا بزرگ دارد. نسخههای چندرسانهای میتوانند تصویر را همراه متن دریافت کنند؛ بنابراین برای پرسش دربارهی نمودار، عکس یا محتوای تصویری هم قابل بررسیاند. مدلهای کوچکتر برای گفتوگوی روزانه مناسبترند و نسخههای بزرگتر کیفیت بالقوهی بیشتری دارند، اما منابع سختافزاری بالاتری میخواهند.
مزایا: انتخاب اندازههای مختلف؛ پشتیبانی از ورودی تصویر در نسخههای مربوط؛ مناسب برای خلاصهسازی، پرسشوپاسخ و تحلیل محتوای تصویری.
معایب: همهی نسخهها یکسان نیستند و بعضی فقط متنیاند؛ کیفیت فارسی را باید جداگانه ارزیابی کرد؛ شرایط استفادهی Gemma اختصاصی است و نباید آن را با مجوزهای آزاد مثل Apache 2.0 یکی دانست.
مناسب چه کسی است؟ کاربری که میخواهد علاوه بر متن، عکس را هم به مدل بدهد یا به یک مدل عمومی با چند گزینهی اندازه نیاز دارد.
۳. DeepSeek-R1؛ برای استدلال و مسئلههای چندمرحلهای
DeepSeek-R1 با تمرکز بر استدلال منتشر شد و نسخههای تقطیرشدهی کوچکتری دارد. تقطیر یعنی دانش یک مدل بزرگتر به مدلی کوچکتر منتقل شود تا اجرای آن سادهتر شود؛ البته نسخهی کوچک معمولاً همهی توان مدل اصلی را ندارد. این خانواده را میتوان برای حل مسئله، تحلیل چندمرحلهای و کمک در کدنویسی آزمود.
مزایا: گزینههای تقطیرشده در اندازههای متنوع؛ مناسب برای مقایسهی پاسخ تحلیلی با مدلهای عمومی؛ مجوز برخی نسخههای اصلی این خانواده آزادتر از مجوزهای اختصاصی است.
معایب: تولید پاسخ استدلالی ممکن است کند و پرحجم باشد؛ پاسخ قانعکننده لزوماً پاسخ درست نیست؛ نسخههای بزرگ در کامپیوتر معمولی بهراحتی جا نمیشوند.
مناسب چه کسی است؟ کسی که کیفیت تحلیل و حل مسئله برایش مهمتر از کوتاهبودن پاسخ یا سرعت لحظهای است.
۴. Llama؛ انتخابی با اکوسیستم گسترده
خانوادهی Llama از گزینههای پرکاربرد برای ساخت چتبات و دستیار محلی است. در کنار مدلهای بزرگ، نسخههای کوچکتری هم وجود دارند که برای آزمایش و استفادهی روزمره عملیترند. یکی از مزیتهای مهم این خانواده، پشتیبانی گستردهی نرمافزارها و ابزارهای محلی از آن است.
مزایا: آموزشها و ابزارهای فراوان؛ انتخابهای مختلف برای چت، خلاصهسازی و نمونهسازی؛ جامعهی کاربری بزرگ.
معایب: همهی مدلهای Llama متنباز به معنای مجوز کاملاً آزاد نیستند و شرایط متا باید بررسی شود؛ کیفیت و توان مدل بین نسلها و اندازهها تفاوت دارد؛ نسخههای قویتر ممکن است برای لپتاپ معمولی سنگین باشند.
مناسب چه کسی است؟ توسعهدهندهای که سازگاری با ابزارها و نمونههای آماده برایش مهم است و پیش از استفادهی تجاری، مجوز را بررسی میکند.
۵. Mistral Small؛ گزینهای برای سختافزار قویتر
Mistral Small نام خانوادهای از مدلهای نسبتاً بزرگ است؛ نسخهی شناختهشدهی 24B به حافظهی بیشتری از مدلهای 7B یا 8B نیاز دارد. در عوض، برای پیروی از دستورها، تولید متن و برخی کارهای پیچیدهتر ارزش آزمایش دارد. مدلهای Mistral در ابزارهای محلی مختلف در دسترساند، اما نام نسخه و شرایط استفاده را دقیق تطبیق دهید.
مزایا: توان قابل توجه در اندازهای کوچکتر از مدلهای بسیار بزرگ؛ مناسب برای چت، تولید متن و وظایف دشوارتر؛ برخی انتشارها با مجوزهای باز عرضه شدهاند.
معایب: 24B برای رایانهی کمحافظه انتخاب سبکی نیست؛ سرعت به GPU و نوع کوانتایزیشن وابستگی زیادی دارد؛ مجوز Mistral در همهی نسخهها یکسان نیست.
مناسب چه کسی است؟ کاربری با رایانهی رومیزی یا لپتاپ قدرتمند که مدل بزرگتر را برای کیفیت پاسخ بهتر میخواهد.
۶. مدلهای تخصصی کدنویسی؛ Qwen Coder و StarCoder
مدل کدنویسیمحور روی کد و کارهای نرمافزاری تمرکز دارد؛ برای تکمیل تابع، توضیح خطا، نوشتن تست اولیه یا تبدیل یک قطعهکد میتواند از مدل عمومی مناسبتر باشد. Qwen Coder و StarCoder نمونههایی از این دستهاند. بهتر است اندازهای را انتخاب کنید که با محیط توسعه و سختافزار شما سازگار باشد.
مزایا: توجه بیشتر به ساختار کد؛ کمک در تکمیل و توضیح قطعهکد؛ امکان استفاده در محیط محلی بدون فرستادن کد به سرویس ابری (در صورتی که برنامهی واسط نیز محلی باشد).
معایب: ممکن است API یا کتابخانهی ناموجود پیشنهاد دهد؛ کد آسیبپذیر یا ناسازگار تولید کند؛ کیفیت آن برای همهی زبانها و نسخههای فریمورک یکسان نیست. هر خروجی را اجرا، تست و از نظر امنیت بررسی کنید.
مناسب چه کسی است؟ برنامهنویسی که میخواهد یک همکار کدنویس محلی داشته باشد، نه اینکه خروجی مدل را بدون بررسی وارد محصول کند.
برای اجرای مدل لوکال چه مقدار حافظه لازم است؟
یک قاعدهی سرانگشتی این است که مدلهای 4B و 8B فشردهشده برای بسیاری از رایانههای شخصی نقطهی شروع واقعبینانهتریاند؛ مدلهای 14B و 24B معمولاً حافظهی بیشتری میطلبند و 30B به بالا برای اجرای روان به سختافزار قویتری نیاز دارد. این اعداد قطعی نیستند: نسخهی Q4 از یک مدل 8B ممکن است حدود چند گیگابایت برای وزنها مصرف کند، اما حافظهی لازم هنگام اجرا با طول متن، کش گفتگو و سربار نرمافزار بیشتر میشود.
GPU با VRAM کافی معمولاً پاسخگویی را سریعتر میکند. اگر GPU مناسب ندارید، اجرای CPU و RAM سیستم هم برای بعضی مدلها ممکن است، ولی سرعت کاهش پیدا میکند. برای انتخاب دقیق، اندازهی فایل مدل، حداقل حافظهی اعلامشده در نرمافزار اجرا و مصرف واقعی حین یک گفتوگوی طولانی را با هم بررسی کنید.
چطور یک مدل را روی کامپیوتر اجرا کنیم؟
راه ساده برای شروع، نصب ابزار محلی مانند Ollama یا LM Studio است. در Ollama پس از نصب برنامه، برچسب نسخهی موجود را از فهرست همان ابزار انتخاب میکنید و دستور اجرای آن را وارد میکنید؛ برای نمونه: ollama run qwen3:8b. نام برچسبها ممکن است تغییر کند، پس اگر فرمان پیدا نشد، نسخهی فعلی خانواده را در کتابخانهی خود ابزار جستوجو کنید. سپس چند درخواست یکسان به دو مدل بدهید و دقت، سرعت، کیفیت فارسی و مصرف حافظه را مقایسه کنید.
اگر محتوا محرمانه است، علاوه بر اجرای مدل، اتصال اینترنت برنامه، افزونهها، تاریخچهی گفتگو و محل ذخیرهی فایلها را هم بررسی کنید. محلیبودن مدل بهتنهایی جایگزین تنظیمات امنیتی مناسب نیست.
کدام مدل هوش مصنوعی لوکال را انتخاب کنیم؟
برای استفادهی عمومی و شروع با مدل کوچک: Qwen3 یا Gemma 3 در اندازهی پایینتر.
برای تحلیل تصویری: نسخهی چندرسانهای Gemma 3 که سختافزار شما پشتیبانی کند.
برای استدلال: نسخهی تقطیرشدهی DeepSeek-R1؛ ابتدا یک نسخهی کوچک را بسنجید.
برای بیشترین سازگاری با ابزارها: یک نسخهی کوچک Llama و بررسی شرایط مجوز.
برای پاسخهای قویتر روی رایانهی توانمند: Mistral Small یا مدل هماندازه.
برای کمک برنامهنویسی: مدل تخصصی کدنویسی و بازبینی دقیق خروجی.
اگر هنوز مطمئن نیستید، ابتدا یک مدل 4B یا 8B را اجرا کنید. برای همان سه کار واقعی خودتان—مثلاً نوشتن فارسی، خلاصهکردن فایل و حل یک مسئله—از دو مدل خروجی بگیرید. مدلی را انتخاب کنید که در دستگاه شما روانتر و در کارهای موردنیازتان دقیقتر باشد؛ نه صرفاً مدلی که نام یا اندازهی بزرگتری دارد.
پرسشهای متداول
آیا مدل هوش مصنوعی لوکال بدون اینترنت کار میکند؟
پس از دانلود وزنها و نصب پیشنیازها، بسیاری از ابزارها میتوانند برای تولید پاسخ به اینترنت نیاز نداشته باشند. دانلود اولیه، بهروزرسانی، افزونهها یا بعضی قابلیتهای برنامه ممکن است همچنان اینترنت بخواهند.
بهترین مدل محلی برای فارسی کدام است؟
یک برندهی ثابت برای همهی کاربردها وجود ندارد. Qwen3 و Gemma 3 نقطهی شروع مناسبی برای آزموناند؛ کیفیت را با متن فارسی واقعی خودتان، شامل محاوره، نیمفاصله و پرسشهای تخصصی، مقایسه کنید.
آیا اجرای مدل روی لپتاپ به کارت گرافیک نیاز دارد؟
خیر، بعضی مدلها با پردازنده و RAM هم اجرا میشوند، اما معمولاً کندترند. GPU با حافظهی کافی میتواند سرعت را افزایش دهد؛ اندازهی مدل و کوانتایزیشن را با منابع دستگاه هماهنگ کنید.
آیا همهی مدلهای معرفیشده واقعاً متنباز هستند؟
همهی آنها وزن قابلدسترسی دارند، اما این موضوع با متنبازبودن کامل یکسان نیست. مجوز، محدودیت استفاده و امکان بهرهبرداری تجاری به مدل و نسخهی دقیق وابسته است؛ پیش از استفادهی حرفهای، متن مجوز همان نسخه را بخوانید.
برای استفادهی تجاری کدام مدل را انتخاب کنم؟
صرفاً بر اساس نام خانواده تصمیم نگیرید. مجوز نسخهی دقیق، محدودیتهای استفاده، الزامات انتساب و سیاست انتشار محصول را بررسی کنید و در صورت ابهام حقوقی از مشاور متخصص کمک بگیرید.